[MLflow] MLflow Client (클라이언트 사이드)
MLflow의 Client Side 구조와 MLflow Client 패키지 알아보기
MLflow Client
1. MLflow Client란
앞선 포스팅들에서 MLflow는 크게 다음과 같은 구성 요소들로 나누어 볼 수 있다고 정리했다.
- MLflow Tracking Server : 실행(Run)과 실험(Experiment)에 대한 정보 수신, 각 Store에 저장하는 중앙 관제탑
- Backend Store : 실행(Run), 실험(Experiment), 모델(Model) 등에 대한 메타데이터를 저장
- Artifact Store : 모델 파일, 이미지, 데이터셋과 같은 객체, 실행 결과물 등을 저장
- MLflow Client
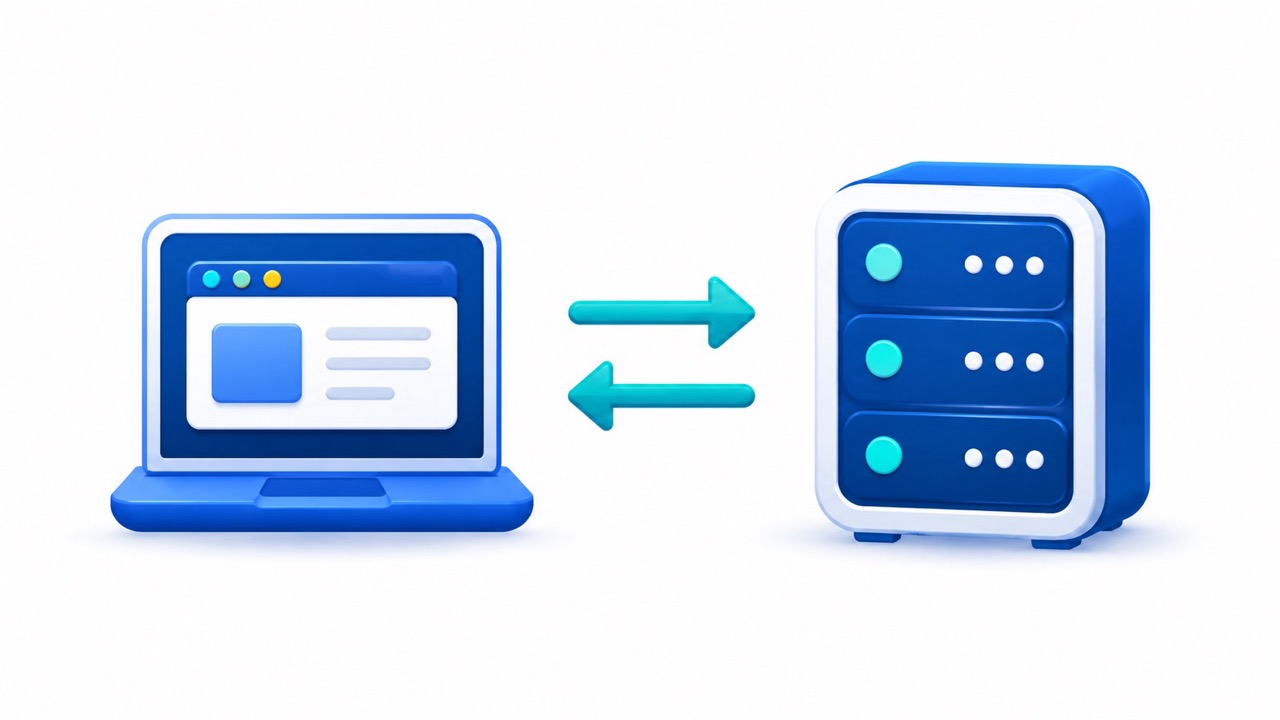
이 중 마지막 MLflow Client에 대해서 알아보자. MLflow Client는 실제 MLflow Tracking Server의 API를 호출하여 실험이나 모델 관련 정보를 기록하고 조회하는 애플리케이션 측를 뜻한다. 일반적으로 모델을 학습하거나 평가하는 코드에서 사용되며, 이 과정에서 발생한 파라미터, 메트릭, 태그, 아티팩트 등을 MLflow Tracking Server에 전달한다.
즉, MLflow Client 사이드는 별도의 서버라기보다는 모델 학습이나 평가 등의 애플리케이션 코드가 실행되면서 MLflow Server와 통신하는 쪽이라고 이해하면 된다. Server Side보다 개발자나 모델러가 직접 사용하는 환경에 더 가깝다.
1
2
3
4
5
6
7
8
9
import mlflow

mlflow.set_tracking_uri("http://localhost:5000")
mlflow.set_experiment("sample-experiment")

with mlflow.start_run():
    mlflow.log_param("learning_rate", 0.01)
    mlflow.log_metric("accuracy", 0.92)
    mlflow.log_artifact("result.txt")
위 코드는 MLflow Client 사이드의 Run 등록 코드다. Run을 생성하고, 해당 Run에서 사용된 하이퍼 파라미터, 성능 정보, 아티팩트(훈련 결과물)을 MLflow Server Side에 기록을 요청한다.
이 코드는 직접 Backend Store나 Artifact Store에 데이터를 저장하지 않는다. 대신, MLflow Tracking Server와 통신하며 Run 생성, 파라미터 및 메트릭 기록, 아티팩트 업로드 등의 요청을 보낸다.
이 요청을 받은 Tracking Server는
- 파라미터, 메트릭, 태그 같은 메타데이터는 Backend Store에 저장하고
- 모델 파일, 이미지, 로그 파일 같은 결과물은 Artifact Store에 저장한다.
2. 왜 Client Side를 따로 생각해야 할까?
MLflow를 처음 설치할 때는 보통 다음 명령어를 사용한다.
1
pip install mlflow
이 명령어는 MLflow의 전체 기능을 사용할 수 있는 표준 패키지를 설치한다. 하지만 실제 운영 구조를 생각해보면, 모든 환경에 전체 기능을 담은 표준 MLflow 패키지가 필요한 것은 아니다.
예를 들어 MLflow Tracking Server 쪽은 여러 사용자의 실험 정보를 받아야 하고, 저장소와도 연결되어야 하며, UI도 제공해야 한다. 따라서 다음과 같은 기능이 필요하다.
- Web UI
- REST API
- Backend Store 연결
- Artifact Store 연결
- Model Registry
반면 Client Side는 조금 다르다. Client Side의 주된 역할은 모델을 학습하고, 그 결과를 Tracking Server로 전송하는 것이다. Web UI는 필요 없으며, 또한 직접 Backend Store를 구동할 필요도 없다. 즉, 다음 기능들만 있어도 충분할 것이다.
- Tracking Server 주소 설정
- Experiment 설정
- Run 생성
- Parameter 기록
- Metric 기록
- Artifact 업로드
- Model 등록 요청
3. MLflow 선택적 설치
앞서 살펴본대로, Client를 가지고 Tracking Server를 통해 저장소에 접근하는 구조라면, Client Side가 DB 의존성을 직접 가질 필요도 없고, UI와 관련된 코드를 가지고 있을 필요도 없다.
그래서 MLflow는 경량 설치 방식을 제공하며, 사용 목적에 따라 여러 패키지로 나누어 설치할 수 있다. 대표적으로 다음과 같은 패키지가 있다.
| 라이브러리 | 주요 기능 | 설치 방법 | 설치 용량(의존성 포함) |
|---|---|---|---|
| mlflow | 모델 로깅, 실험 관리, 모델 레지스트리, 모델 서빙 등 MLflow의 모든 기능을 포함한 표준 패키지 | pip install mlflow |
약 484 MB |
| mlflow-tracing | LLM/GenAI 애플리케이션의 트레이싱(관찰/모니터링)만을 위한 초경량 패키지 모델 로깅, 실험 관리, 모델 레지스트리 등은 지원하지 않음 |
pip install mlflow-tracing |
약 48 MB |
| mlflow-skinny | 서버, UI, 데이터사이언스 관련 의존성을 제외한 경량 패키지 기본적인 트래킹과 모델 레지스트리, 프로젝트 실행 등은 가능 |
pip install mlflow-skinny |
약 63 MB |
용량은 MLflow 3.16.1, macOS 환경에서 각 패키지를 빈 가상환경에 설치한 후 의존성을 포함하여 측정하였다. 설치 용량은 Python 버전과 운영체제 등에 따라 달라질 수 있으므로 패키지 간 상대적인 크기를 비교하는 용도로만 참고하길 바란다.
여기서 Client Side에서 가장 자주 고려할 수 있는 패키지는 mlflow-skinny이다. 이는 이름 그대로 가벼운 MLflow 패키지로, 공식 설명에서도 SQL Storage, Server, UI, 데이터사이언스 관련 의존성을 제외한 경량 MLflow 패키지라고 설명하고 있다.
즉, 모델 학습 코드에서 Tracking Server로 실험 정보를 보내는 목적이라면, 처음부터 전체 mlflow 패키지를 설치하지 않고 mlflow-skinny를 사용하는 선택지가 있다.
4. mlflow와 mlflow-skinny의 차이
간단히 말하면 다음과 같다.
mlflow
- MLflow 전체 기능 설치
- 서버 실행, UI, 모델 서빙, 다양한 모델 flavor, SQL Storage 관련 기능까지 포함
- Tracking Server나 로컬에서 모든 기능을 실험할 때 적합
mlflow-skinny
- Client Side에서 필요한 최소 기능 중심
- 서버, UI, SQL Storage, 데이터사이언스 관련 의존성을 제외
- 원격 Tracking Server에 실험 정보를 기록하는 학습 코드에 적합
예를 들어 MLflow Tracking Server를 별도로 운영하고 있고, 학습 코드는 다른 서버나 노트북 환경에서 실행한다고 하자. 이 경우 Client Side에서는 다음 정도의 작업만 수행하면 된다.
1
2
3
4
5
6
7
8
import mlflow

mlflow.set_tracking_uri("http://mlflow.example.com:5000")
mlflow.set_experiment("train-model")

with mlflow.start_run():
    mlflow.log_param("model", "resnet")
    mlflow.log_metric("accuracy", 0.95)
이때는 MLflow UI를 실행하지 않으며, Backend Store를 직접 제어하지도 않는다. 그리고 Artifact Store를 직접 관리하는 서버도 아니다. 그저 학습 코드에서 발생한 정보를 Tracking Server로 보낼 뿐이다. 이런 상황에서는 전체 MLflow 패키지보다 mlflow-skinny가 더 적합할 수 있다.
5. 주의할 점
하지만 mlflow-skinny가 항상 정답은 아니다. Client Side라고 하더라도, 학습 코드에서 특정 ML 프레임워크의 모델 로깅 기능을 사용한다면 추가 의존성이 필요할 수 있다.
예를 들어 scikit-learn 의 기능을 사용하고 싶을 경우, mlflow에 내장된 sklearn 모듈을 사용하는 것이 편리할 것이고, 이때는 skinny 보다는 mlflow 전체 패키지를 설치하는 게 나을 수도 있다.
1
mlflow.sklearn.log_model(...)
또는 PyTorch, TensorFlow, XGBoost 같은 모델 flavor를 사용한다면 해당 프레임워크가 설치되어 있어야 하며, 서버 실행, UI 실행, SQL 기반 저장소 직접 사용, 모델 서빙 기능이 필요하다면 mlflow-skinny만으로는 부족할 수 있다.
즉, 상황에 맞게 알맞은 패키지를 선택해야 한다.
| 상황 | 권장 설치 |
|---|---|
| MLflow 기능을 전체적으로 실습하고 싶음 | pip install mlflow |
| Tracking Server를 직접 실행해야 함 | pip install mlflow |
| UI, Serving, SQL Storage 관련 기능이 필요함 | pip install mlflow |
| 원격 Tracking Server를 중심으로 Client 기능을 사용함 | pip install mlflow-skinny |
| 필요한 ML Flavor만 별도로 구성하고 싶음 | mlflow-skinny + 필요한 라이브러리 |
| LLM/GenAI Trace 수집만 필요함 | pip install mlflow-tracing |
Reference
https://mlflow.org/docs/latest/api_reference/python_api/mlflow.client.html
https://pypi.org/project/mlflow-skinny/3.16.1/
https://mlflow.org/docs/latest/ml/tracking/tracking-api?
https://mlflow.org/docs/latest/api_reference/python_api/mlflow.config.html
// reading compass
이 글과 이어지는 경로
시리즈, 카테고리, 태그 겹침, 최신도를 점수화해 가까운 글일수록 중심에 배치합니다.
댓글 남기기